속성 그래프 모델#
AgensGraph는 데이터를 두 가지 모양으로 동시에 저장합니다. 관계형 테이블로, 그리고 속성 그래프로입니다. 이 페이지는 그중 그래프 쪽을 정의합니다 — 그래프를 이루는 다섯 가지, 그리고 AgensGraph에서 그 각각이 지키는 규칙입니다.
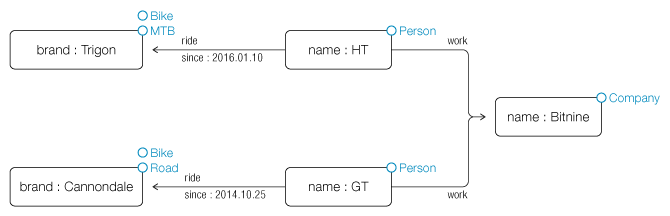
정점#
정점은 개체입니다. 사람, 영화, 계정, 센서 같은 것입니다. 정점에는 식별자와 레이블이 있고, 속성은 몇 개든 가질 수 있습니다.
정점은 정확히 하나의 레이블에 속합니다. 이전에 써 본 그래프 데이터베이스와 가장 다를 만한 규칙입니다 — 정점마다 레이블 집합을 갖는 방식이 아닙니다. 한 정점에 여러 레이블을 붙이고 싶은 상황이라면 대신 레이블 상속을 쓰십시오. 하나의 패턴이 레이블 계열 전체에 일치하게 해 줍니다.
간선#
간선은 두 정점을 연결합니다. 간선에는 식별자, 레이블, 몇 개든 가질 수 있는 속성, 그리고 방향이 있습니다. 간선에는 항상 시작 정점과 끝 정점이 있습니다.
AgensGraph에서 성립하는 규칙이 세 가지 있습니다:
간선에는 항상 레이블이 있습니다. 레이블 없는 간선은 없습니다.
간선에는 항상 양 끝점이 있습니다. 매달린 간선은 존재할 수 없으므로, 아직 간선이 남아 있는 정점을 지우려 하면 거부됩니다:
ERROR:  Vertex with connected edges cannot be removed
HINT:  Use DETACH DELETE or remove connected edges before deleting the vertex.
방향은 기록되지만, 그 방향에 맞추는 것은 선택입니다. 간선은 한 방향으로 저장해 두고, 방향이 중요한지는 쿼리마다 정합니다.
-[:acted_in]->는 방향을 따르고,-[:acted_in]-는 무시합니다. 간선을 거울처럼 뒤집어 하나 더 저장할 이유가 없습니다.
속성#
속성은 정점이나 간선에 담긴 데이터입니다. 속성에는 문자열 이름과 값이 있습니다.
속성은 요소마다 하나의 jsonb 문서로 저장되므로, 값은 어떤 JSON 타입이든 될 수 있습니다.
문자열, 숫자, 불리언, 배열, 중첩된 객체입니다. 여기서 두 가지가 따라옵니다:
레이블은 컬럼 목록을 강제하지 않습니다. 같은 레이블을 가진 두 정점이 완전히 다른 속성 이름을 가질 수 있습니다. 미리 선언해 둘 것이 없습니다.
null은 속성 값이 아닙니다.null을 할당하면 그 속성이 지워집니다:MATCH (n:person {name: 'Tmp'}) SET n.born = NULL RETURN n; person[4.40]{"name": "Tmp"}
그러므로 null로 설정한 속성과 애초에 없던 속성은 같은 것입니다.
allow_null_properties를 켜면 이 동작이 달라져 null이 저장됩니다:person[4.40]{"born": null, "name": "Tmp"}
읽기가 JSON 문서 안으로 들어가야 하므로, 모든 쿼리가 필터에 쓰는 속성이라면 타입 컬럼으로 승격할 만합니다. 이것은 모델링의 선택이 아니라 성능의 선택입니다 — 속성은 그대로 속성으로 남습니다.
참고
n.id는 정점의 식별자가 아닙니다. id라는 이름의 속성을 읽는 것이며, 그런 속성은 보통
존재하지 않습니다. 식별자는 id(n)입니다.
레이블#
레이블은 같은 종류의 요소를 묶습니다. movie, person, acted_in이 레이블입니다.
레이블은 인덱스를 붙이는 대상이고, 권한을 부여하는 대상이며, 패턴이 검색 범위를 좁히려고
이름으로 부르는 대상입니다. 정점 레이블과 간선 레이블은 서로 다른 종류이고, 각각
CREATE VLABEL과 CREATE ELABEL로 만들며, 한 그래프 안에서 이름은 한 번만 쓸 수 있습니다.
모든 그래프는 선언하지 않은 레이블 두 개와 함께 만들어집니다. ag_vertex와 ag_edge입니다.
직접 만드는 모든 레이블은 그중 하나를 상속합니다. MATCH (n)처럼 레이블 없는 패턴이 “임의의
정점”을 뜻하게 되는 것이 이 상속 덕분입니다. 레이블을 전혀 주지 않고 만든 정점은 ag_vertex에
놓입니다:
CREATE ({tmp: 1});
MATCH (n:ag_vertex ONLY) RETURN label(n) AS label, id(n) AS id, n.tmp;
    label    | id  | tmp
-------------+-----+------
 "ag_vertex" | 1.3 | 1
기본 레이블을 직접 이름으로 지정할 수는 없습니다:
CREATE (:ag_vertex {tmp: 1});
ERROR: specifying default label is not allowed
레이블 이름은 큰따옴표로 감싸지 않으면 소문자로 접힙니다. PostgreSQL이 따옴표 없는 식별자를 접는 것과 같습니다. 여기서 백틱은 인용 문자가 아닙니다 — 구문을 참고하십시오.
경로#
경로는 간선으로 이어진 정점의 나열입니다. 경로 자체가 하나의 값이므로, 변수에 바인딩하고, 반환하고, 그 길이나 구성원을 물을 수 있습니다.
MATCH p = (a:person {name: 'Keanu Reeves'})-[:acted_in]->(m:movie)
RETURN length(p) AS hops, a.name AS actor, m.title AS film
ORDER BY film LIMIT 2;
 hops |     actor      |         film
------+----------------+-----------------------
 1    | "Keanu Reeves" | "The Matrix"
 1    | "Keanu Reeves" | "The Matrix Reloaded"
경로의 길이는 그 간선의 개수입니다. 그러므로 정점 하나는 길이 0인 경로이고, 자기 자신으로 가는 간선은 길이 1인 경로입니다. “몇 홉이든”을 표현하는 방법이 경로입니다. 가변 길이 패턴, 최단 경로, 가중 탐색은 경로를 참고하십시오.
그래프#
그래프는 레이블을 담는 그릇이고, 데이터베이스는 여러 개를 가질 수 있습니다. 그래프는 동시에 PostgreSQL 스키마이므로 그래프 이름과 스키마 이름은 충돌할 수 없습니다 — 그래프가 어떻게 저장되는가를 참고하십시오.
세션은 한 번에 하나의 그래프에서 작업하며, 그 그래프는 graph_path로 지정합니다:
SET graph_path = moviekb;
이것이 없으면 아무것도 해석되지 않습니다:
ERROR:  graph_path is NULL
HINT:  Use SET graph_path
graph_path는 그래프 이름을 정확히 하나만 받으며, 패턴에서 레이블을 그래프 이름으로 수식할 수는
없습니다 — MATCH (n:other.work)는 구문 오류입니다. 한 문장에서 두 그래프를 읽으려면 SQL을
쓰십시오. SQL은 그 둘을 두 개의 스키마로 봅니다:
CREATE GRAPH other;
SET graph_path = other;
CREATE VLABEL work;
CREATE (:work {title: 'A'}), (:work {title: 'B'});
SET graph_path = moviekb;
SELECT (SELECT count(*) FROM moviekb.movie) AS movies,
       (SELECT count(*) FROM other.work)    AS works;
 movies | works
--------+-------
     18 |     2
DROP GRAPH other CASCADE;
graph_path는 세션 단위 설정이므로, 모든 세션이 같은 그래프를 쓴다면 데이터베이스에 설정해
두십시오:
ALTER DATABASE mydb SET graph_path = moviekb;