데이터 모델
AgensGraph는 멀티 모델 데이터베이스입니다. AgensGraph는 속성 그래프 모델과 관계형 모델을 동시에 지원합니다.
속성 그래프 모델
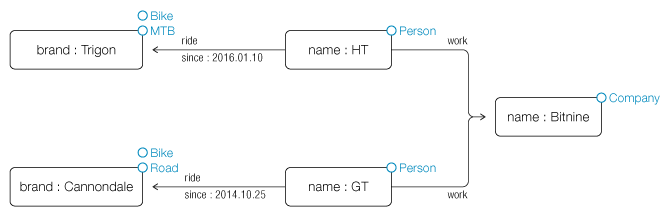
속성 그래프 모델은 연결된 엔티티들로 구성되며, 각 엔티티는 임의 개수의 속성을 가질 수 있습니다. AgensGraph에서 엔티티는 정점(vertex)이라고 합니다. 정점은 임의 개수의 속성을 가질 수 있으며 레이블로 분류할 수 있습니다. 레이블은 정점을 그룹화하여 특정 범주의 정점을 나타내기 위해 사용됩니다. 예를 들어 사람의 역할을 나타내는 데 사용됩니다.
간선(edge)은 두 정점 사이의 방향성 연결입니다. 간선도 정점과 마찬가지로 속성을 가질 수 있으며 레이블로 분류할 수 있습니다. AgensGraph에서 간선은 항상 시작 정점과 끝 정점을 가집니다. 쿼리에서 정점을 삭제하려면 먼저 해당 정점의 모든 간선을 삭제해야 합니다. AgensGraph에는 끊어진 간선이 존재할 수 없습니다.
간선과 정점의 속성은 JSON 형식으로 표현됩니다. JSON은 반정형 데이터를 직렬화하기 위한 텍스트 형식입니다. JSON은 문자열, 숫자, 불리언, null, 객체, 배열의 여섯 가지 데이터 타입으로 구성됩니다. AgensGraph 객체는 정보를 0개 이상의 이름/값 쌍의 순서 없는 컬렉션으로 저장함으로써 JSON 형식을 최대한 활용합니다. 이름은 문자열이며, 값은 중첩된 JSON 타입을 포함하여 앞서 언급한 어떤 타입이든 될 수 있습니다. AgensGraph는 구체적으로 JSONB 형식을 사용합니다. JSONB는 분해된 바이너리 형식이므로 일반 JSON보다 훨씬 빠르게 처리되지만, 입력 시간은 약간 느려지는 단점이 있습니다.
하나의 데이터베이스에 여러 개의 그래프를 생성할 수 있습니다. 어떤 그래프를 사용할지 지정하려면 세션 매개변수 graph_path를 사용합니다.
현재 graph_path를 확인하려면 다음 명령을 사용합니다.
SHOW graph_path;
CREATE GRAPH로 그래프를 생성할 때 graph_path가 설정되어 있지 않으면, graph_path는 생성된 그래프로 설정됩니다. 여러 개의 그래프를 생성한 후 다음 명령을 사용하여 graph_path를 다른 그래프로 변경할 수 있습니다.
SET graph_path = graphname;
graph_path는 세션 변수이므로, 모든 클라이언트는 그래프를 쿼리하기 전에 graph_path를 설정해야 합니다. graph_path에는 하나의 그래프 이름만 지정할 수 있습니다. 여러 그래프에 걸친 쿼리는 허용되지 않습니다.
ALTER ROLE 또는 DATABASE 구문을 사용하여 각 사용자 또는 데이터베이스에 대해 graph_path를 설정해 두면, 데이터베이스에 연결할 때마다 SET graph_path 구문을 실행할 필요가 없습니다.
ALTER ROLE user1 IN DATABASE gdb SET graph_path TO graphname;
ALTER DATABASE gdb SET graph_path TO graphname;
DROP
DROP GRAPH graphname CASCADE;
그래프에는 정점과 간선을 위한 초기 레이블이 있습니다. 이러한 레이블은 삭제할 수 없습니다. 그래프를 삭제하려면 사용자는 CASCADE 옵션을 사용해야 합니다. 현재 graph_path가 삭제된 그래프인 경우, graph_path는 null로 재설정됩니다.
레이블
CREATE
CREATE VLABEL person;
CREATE VLABEL friend inherits (person);

CREATE ELABEL knows;
CREATE ELABEL live_together;
CREATE ELABEL room_mate inherits (knows, live_together);
VLABEL과 ELABEL 키워드는 각각 정점과 간선을 식별하는 데 사용됩니다. CREATE VLABEL은 정점 레이블을 생성합니다. VLABEL은 VLABEL만 상속할 수 있습니다(즉, VLABEL은 ELABEL을 상속할 수 없습니다). inherits는 상위 레이블을 상속하기 위한 옵션입니다. 지정하지 않으면 시스템은 초기 레이블을 상위 레이블로 설정합니다. 복잡한 레이블을 생성하기 위해 다중 상속도 가능합니다.
DROP
DROP VLABEL friend;
DROP VLABEL person;
VLABEL friend는 person을 상속하므로, VLABEL person을 직접 삭제할 수 없습니다. VLABEL friend를 먼저 삭제해야 합니다.
레이블이 어떤 정점이나 간선에 바인딩되어 있는 경우, DROP VLABEL 또는 DROP ELABEL을 사용하여 해당 레이블을 삭제할 수 없습니다.
DROP VLABEL person;
ERROR:  cannot drop person because it is not empty.
레이블이 바인딩되어 있는지 여부와 관계없이 레이블을 삭제하려면 DROP ... CASCADE를 사용할 수 있으며, 이 경우 해당 레이블을 가진 모든 데이터 객체가 함께 삭제됩니다.
DROP VLABEL person CASCADE;
NOTICE:  drop cascades to vlabel friend
DROP VLABEL

DROP ELABEL knows CASCADE;
상세 설명
GRAPH
CREATE GRAPH
CREATE GRAPH [ IF NOT EXISTS ] graph_name [AUTHORIZATION role_name];
IF NOT EXISTS
같은 이름이 이미 존재하면 아무 작업도 수행하지 않습니다.
AUTHORIZATION role_name
새 그래프를 소유할 사용자의 롤 이름입니다.
ALTER GRAPH
ALTER GRAPH graph_name RENAME TO new_name;
ALTER GRAPH graph_name OWNER TO { new_owner | CURRENT_USER | SESSION_USER };
graph_name
기존 그래프의 이름입니다.
RENAME TO new_name
이 형식은 그래프의 이름을 new_name으로 변경합니다.
OWNER TO new_owner
이 형식은 그래프의 소유자를 변경합니다.
LABEL
CREATE LABEL
VLABEL과 ELABEL의 구문 요약은 동일합니다.
CREATE [ UNLOGGED ] VLABEL [ IF NOT EXISTS ] label_name [DISABLE INDEX]
       [ INHERITS ( parent_label_name [, ...] ) ]
       [ WITH (storage_parameter)]
       [ TABLESPACE tablespace_name ];
UNLOGGED
unlogged 레이블에 기록된 데이터는 write-ahead log에 기록되지 않으므로, unlogged 레이블은 logged 레이블보다 상당히 빠릅니다. 그러나 unlogged 레이블은 충돌에 안전하지 않습니다.
IF NOT EXISTS
같은 이름이 이미 존재하면 아무 작업도 수행하지 않습니다.
label_name
생성할 정점/간선 레이블의 이름입니다.
DISABLE INDEX
유효하지 않은 인덱스를 가진 레이블을 생성합니다. 유효하지 않은 인덱스는 재인덱싱하기 전까지 검색이나 삽입에 사용할 수 없습니다.
INHERITS ( parent_label [, …] )
선택적인 INHERITS 절은 정점/간선 레이블의 목록을 지정합니다. 비어 있으면 새 레이블은 초기 레이블을 상속합니다. INHERITS를 사용하면 새 하위 레이블과 그 상위 레이블 사이에 영구적인 간선이 생성됩니다. 하위 레이블의 데이터는 기본적으로 상위 레이블의 스캔에 포함됩니다.
TABLESPACE tablespace_name
새 레이블은 이름이 tablespace_name인 테이블스페이스에 생성됩니다.
ALTER LABEL
ALTER [ IF EXISTS ] VLABEL label_name RENAME TO new_name;
ALTER [ IF EXISTS ] VLABEL label_name OWNER TO new_owner;
ALTER [ IF EXISTS ] VLABEL label_name SET STORAGE { PLAIN | EXTERNAL | EXTENDED | MAIN };
ALTER [ IF EXISTS ] VLABEL label_name SET TABLESPACE new_tablespace;
ALTER [ IF EXISTS ] VLABEL label_name CLUSTER ON idxname;
ALTER [ IF EXISTS ] VLABEL label_name SET WITHOUT CLUSTER;
ALTER [ IF EXISTS ] VLABEL label_name SET LOGGED;
ALTER [ IF EXISTS ] VLABEL label_name SET UNLOGGED;
ALTER [ IF EXISTS ] VLABEL label_name INHERIT parent_label;
ALTER [ IF EXISTS ] VLABEL label_name NO INHERIT parent_label;
ALTER [ IF EXISTS ] VLABEL label_name DISABLE INDEX;
IF EXISTS
레이블이 존재하지 않더라도 오류를 발생시키지 않습니다.
label_name
기존 정점/간선 레이블의 이름입니다.
RENAME TO new_name
레이블의 이름을 new_name으로 변경합니다.
OWNER TO new_owner
레이블의 소유자를 변경합니다.
SET STORAGE
이 형식은 속성의 저장 모드를 설정합니다. 이는 속성을 인라인으로 보관할지 보조 TOAST 테이블에 보관할지, 그리고 데이터를 압축할지 여부를 제어합니다.
PLAIN은 고정 길이의 인라인이며 압축되지 않은 값에 사용해야 합니다.
MAIN은 인라인이며 압축됩니다.
EXTERNAL은 외부 저장이며 압축되지 않습니다.
EXTENDED는 외부 저장이며 압축됩니다.
SET TABLESPACE
이 형식은 레이블의 테이블스페이스를 지정된 테이블스페이스로 변경하고 데이터 파일을 새 테이블스페이스로 이동합니다. 레이블의 인덱스는 이동되지 않습니다.
CLUSTER/WITHOUT CLUSTER
이 형식은 향후 cluster 작업을 위한 기본 인덱스를 선택/제거합니다. 여기를 참조하십시오.
SET LOGGED/UNLOGGED
이 형식은 레이블을 unlogged에서 logged로 또는 그 반대로 변경합니다.
INHERIT/NO INHERIT
이 형식은 대상 레이블을 상위 레이블의 하위 목록에 추가하거나 제거합니다.
DISABLE INDEX
이 형식은 레이블의 모든 인덱스를 유효하지 않은 인덱스로 변경합니다. 유효하지 않은 인덱스는 재인덱싱하기 전까지 검색이나 삽입에 사용할 수 없습니다.
속성 인덱스
속성 인덱스는 속성 값에 대한 인덱스를 구축하는 방법을 제공합니다. 사용자는 표현식에 대한 인덱스도 생성할 수 있습니다.
CREATE INDEX
CREATE [UNIQUE] PROPERTY INDEX [CONCURRENTLY] [IF NOT EXIST] indexname
ON labelname [USING method]
( attribute_expr | (expr) [COLLATE collation] [opclass] [ASC | DESC]
[NULLS {FIRST | LAST}]  )
[WITH] (storage_parameter = value [,...])
[TABLESPACE tablespacename]
[WHERE predicate];
UNIQUE
데이터가 이미 존재하는 경우 인덱스가 생성될 때, 그리고 데이터가 추가될 때마다 시스템이 테이블에서 중복 값을 검사하도록 합니다. 중복 항목이 발생할 데이터를 삽입하거나 업데이트하려고 시도하면 오류가 발생합니다.
CONCURRENTLY
이 옵션을 사용하면 레이블에 대한 동시 CREATE, DELETE(DETACH), SET를 차단하는 잠금을 취하지 않고 인덱스가 구축됩니다. 이 옵션을 사용할 때 유의해야 할 몇 가지 주의 사항이 있습니다. 여기를 참조하십시오.
IF NOT EXIST
같은 이름이 이미 존재하면 아무 작업도 수행하지 않습니다.
indexname
생성할 인덱스의 이름입니다. 생략하면 AgensGraph가 적절한 이름을 선택합니다.
labelname
인덱싱할 레이블의 이름입니다.
USING METHOD
사용할 인덱스 방식의 이름입니다. btree, hash, gist, spgist, gin, brin이 있습니다. 기본 방식은 btree입니다.
attribute_expr
속성의 어트리뷰트를 가리키는 표현식입니다.
COLLATE collation
인덱스에 사용할 collation의 이름입니다. 기본적으로 인덱스는 인덱싱할 칼럼에 대해 선언된 collation 또는 인덱싱할 표현식의 결과 collation을 사용합니다. 기본값이 아닌 collation을 사용하는 인덱스는 기본값이 아닌 collation을 사용하는 표현식이 포함된 쿼리에 유용할 수 있습니다.
opclass
operator class의 이름입니다.
ASC | DESC
오름차순/내림차순 정렬 순서를 지정합니다. ASC가 기본값입니다.
NULLS { FIRST | LAST }
null을 non-null보다 앞/뒤에 정렬하도록 지정합니다. ASC가 지정된 경우 LAST가 기본값입니다.
WITH storage_parameter
인덱스 방식별 storage parameter의 이름입니다. 자세한 내용은 Index Storage Parameters를 참조하십시오.
TABLESPACE tablespacename
인덱스를 생성할 테이블스페이스입니다.
WHERE predicate
부분 인덱스에 대한 제약 조건 표현식입니다.
DROP INDEX
DROP PROPERTY INDEX indexname [CASCADE | RESTRICT];
indexname
indexname은
ag_property_indexes또는\dGi로 확인할 수 있습니다.
CASCADE
그래프에 의존하는 객체를 자동으로 삭제합니다.
RESTRICT
어떤 객체라도 인덱스에 의존하는 경우 인덱스 삭제를 거부합니다. 이것이 기본값입니다.
제약 조건
이 섹션에서는 속성에 제약 조건을 사용하는 방법에 대한 정보를 제공합니다. 사용자는 UNIQUE 제약 조건과 CHECK 제약 조건의 두 가지 유형의 제약 조건을 생성할 수 있습니다.
CREATE CONSTRAINT constraint_name ON label_name ASSERT field_expr IS UNIQUE;
CREATE CONSTRAINT constraint_name ON label_name ASSERT check_expr;
DROP CONSTRAINT constraint_name ON label_name;
field_expr
이 형식은 JSON 표현식을 나타냅니다. 이 JSON은 중첩된 JSON일 수 있습니다.
UNIQUE
이 형식은 json_expression이 고유한 값만 포함할 수 있도록 지정합니다.
check_expr
check 표현식은 새로 추가되거나 업데이트된 속성에 대해 불리언 결과를 반환합니다. 삽입 또는 업데이트가 성공하려면 결과가 TRUE 또는 UNKNOWN이어야 합니다. 삽입 또는 업데이트 작업의 어떤 속성이라도 FALSE 결과를 생성하면 오류 예외가 발생하고 삽입 또는 업데이트가 롤백됩니다.